-
퍼온글 2개 vLLM vs Ollama vs SGLang vs TensorRT-LLM카테고리 없음 2026. 10. 1. 01:28
GPU 메모리의 80%가 낭비되고 있습니다. 이 네 가지 엔진이 그 문제를 해결해 줍니다.
2026년 4월 10일Llama 70B는 노트북에서 완벽하게 작동합니다. FastAPI로 감싸면 첫 번째 요청 처리 시간이 2.3초로 단축됩니다. 아주 훌륭해 보입니다. 그런데 팀의 엔지니어 세 명이 사용하기 시작합니다.
Request 1:  2.8s   ← looks fine
Request 2:  9.1s   ← why is this slower?
Request 3:  22.4s  ← something is very wrong
Request 4:  torch.cuda.OutOfMemoryError
세 명의 사용자가 A100 보드를 사용 중인데, GPU 메모리가 부족해졌습니다.
모델 자체가 문제는 아닙니다. 직접 model.generate()호출하는 방식은 GPU 메모리를 대부분 낭비하고 요청을 하나씩 처리합니다. 필요한 건 서비스 엔진입니다. 2026년에는 이 문제를 해결하는 방식이 완전히 다른 네 가지 강력한 경쟁자가 있습니다. 잘못된 엔진을 선택하면 GPU 사용료를 3배나 더 많이 지불하거나 데모 버전이 제품으로 전환될 때 마이그레이션에 엄청난 시간을 허비하게 될 것입니다.
실제로 결정하는 방법은 다음과 같습니다.
요약
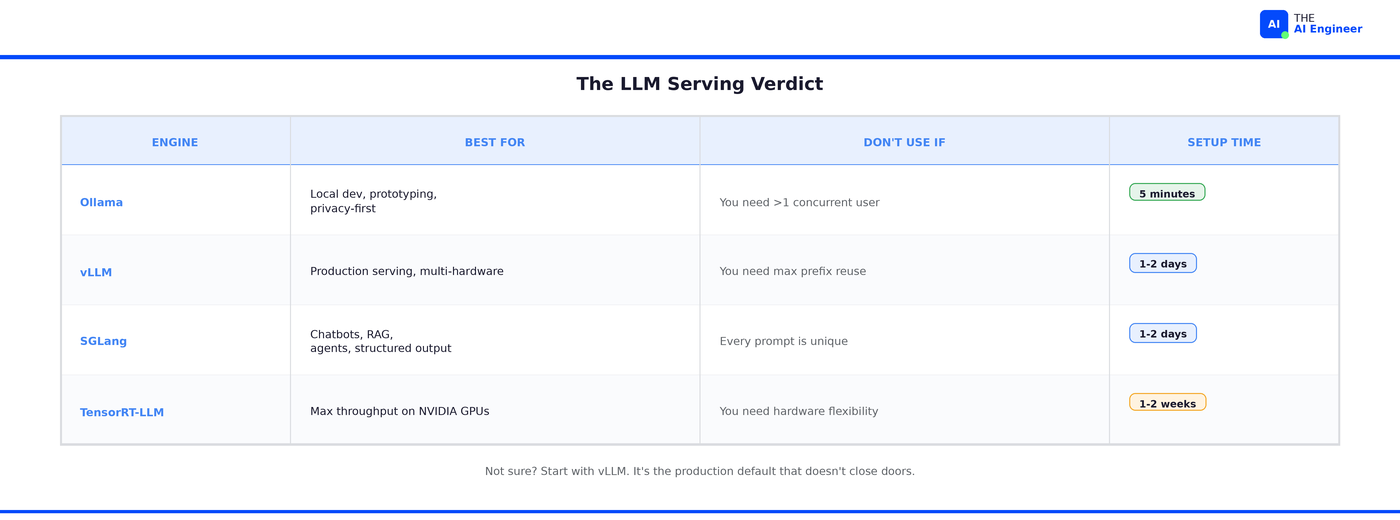
- Ollama는 5분 이내에 로컬에서 모델을 실행해야 하는 경우에 적합한 선택입니다. 개발자 경험은 타의 추종을 불허하지만, 단일 사용자 워크로드 이상으로 확장하기는 어렵습니다.
- vLLM은 프로덕션 환경에서 기본적으로 사용되는 방식입니다 . 핵심 기술(PagedAttention)은 GPU가 빈 슬롯에 메모리를 낭비하는 것을 방지하여 동일한 하드웨어에서 더 많은 사용자를 처리할 수 있도록 합니다. 또한 가장 광범위한 하드웨어에서 실행됩니다. 특별한 이유가 없는 한 vLLM부터 시작하는 것이 좋습니다.
- SGLang은 요청들이 동일한 컨텍스트를 공유하는 경우(챗봇, RAG, 에이전트 등) 처리량 측면에서 vLLM보다 29% 더 우수합니다. 핵심 기술(RadixAttention)은 공유 연산을 캐싱하여 재실행을 방지합니다. 특히 다중 턴 애플리케이션에 매우 효과적입니다.
- TensorRT-LLM은 NVIDIA 하드웨어에서 최대 성능을 끌어내지만, 설정에 1~2주가 소요되며 특정 공급업체에 종속됩니다.
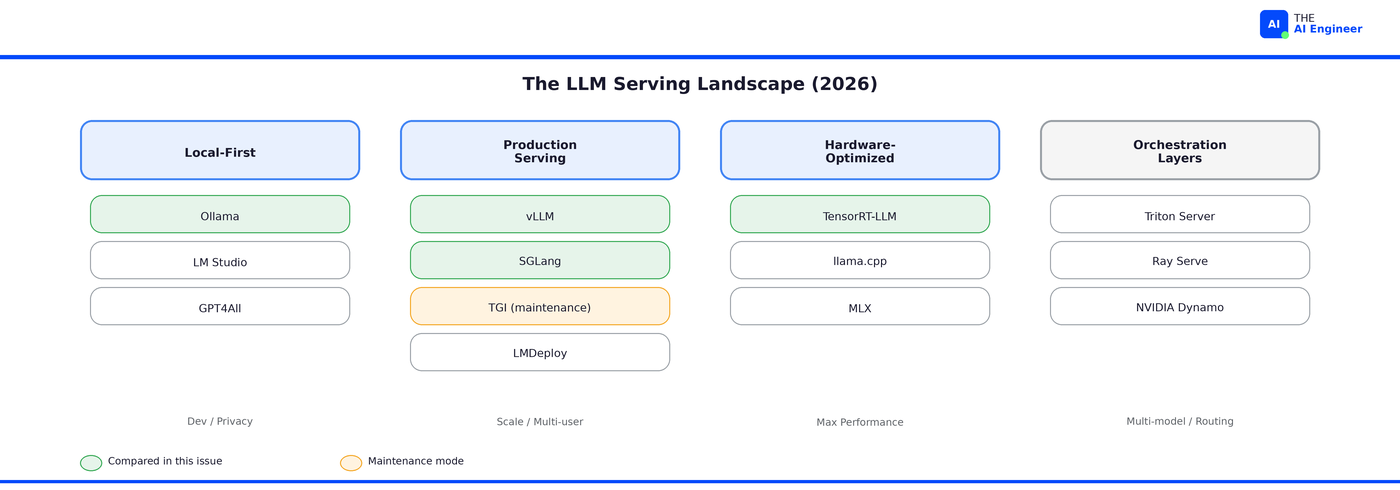
- TGI(HuggingFace)가 공식적으로 유지보수 모드로 전환되었습니다. HuggingFace 측에서도 vLLM 또는 SGLang 사용을 권장합니다. TGI를 아직 사용 중이시라면 지금이 마이그레이션을 고려해야 할 시점입니다.
다음으로는 추론이 느리고 비용이 많이 드는 이유와 이것이 GPU 비용에 미치는 영향에 대해 자세히 살펴보겠습니다. 놓치지 마세요.
구독하다풍경: 우리가 대체 무엇을 비교하고 있는 걸까?
파이썬에서 모델을 직접 호출하면 한 번에 하나의 요청만 처리하고 사용하지 않는 메모리를 과도하게 차지합니다. 서빙 엔진은 이 두 가지 문제를 모두 해결합니다. 여러 요청을 큐에 저장하고 GPU에 효율적으로 처리하며 앱에서 호출할 수 있는 API를 제공합니다. 영상 초반에 나왔던 OOM(메모리 부족) 오류는 중간에 서빙 엔진이 없었기 때문에 발생한 것입니다.
새로운 토큰을 생성할 때마다 GPU 시간이 소모되고, 각 요청이 사용하는 메모리 양은 대화 시간이 길어질수록 증가합니다. 동시 접속 사용자 수를 곱하면 GPU 메모리가 빠르게 부족해집니다. 다음 호에서 정확한 이유를 자세히 살펴보겠습니다. 현재로서는 서버 엔진이 이러한 제약을 지능적으로 관리하기 위해 존재합니다.
📗 필수 조건: GPU가 생소하다면, " GPU란 무엇인가?" 부터 읽어보세요 .
이 글에서 자주 등장하는 용어가 하나 있습니다. 바로 KV 캐시입니다. 모델은 생성 과정에서 이전에 처리했던 모든 토큰에 대한 중간 계산 결과(키-값 쌍)를 저장합니다. 이를 통해 새로운 토큰이 생성될 때마다 어텐션 연산을 처음부터 다시 계산하는 것을 방지할 수 있습니다.
문제는 캐시가 토큰과 동시 요청이 발생할 때마다 커진다는 것입니다. Llama 70B에서 단일 시퀀스는 1.7GB의 캐시를 소모할 수 있습니다. 동시 사용자가 10명이라고 가정하면, 모델 가중치 자체에 사용된 VRAM보다 캐시에 더 많은 VRAM이 사용되는 셈입니다.
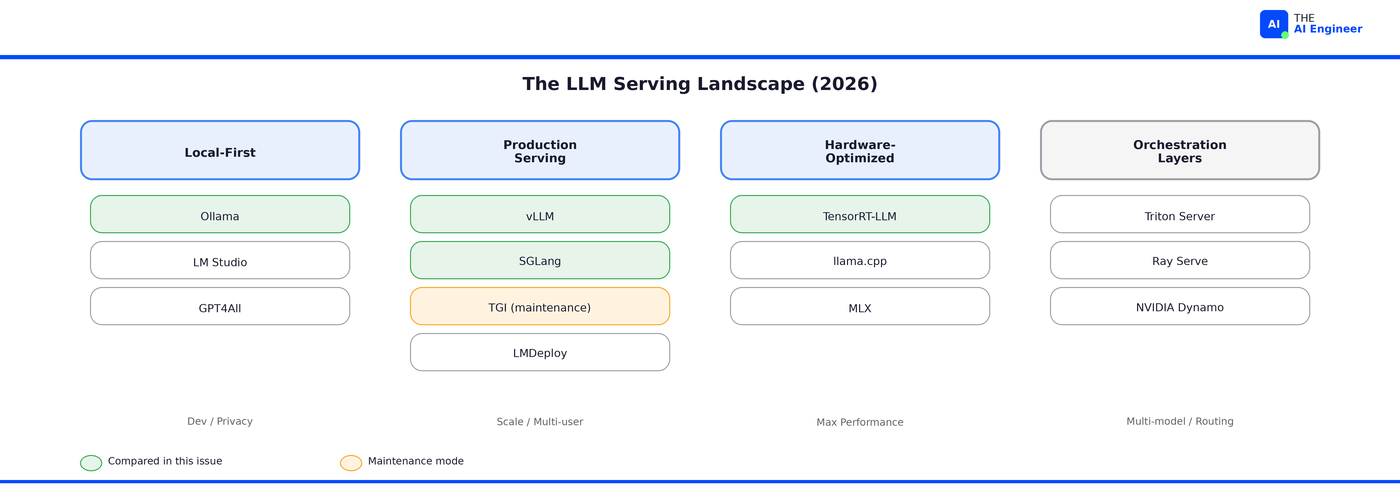
풍경은 혼잡합니다. LLM 서비스 엔진은 크게 네 가지 범주로 나뉩니다.
- 로컬 우선 런타임(Ollama, LM Studio, GPT4All)
- 프로덕션 환경 지원 프레임워크(vLLM, SGLang, TGI, LMDeploy)
- 하드웨어 최적화 엔진(TensorRT-LLM, CUDA를 사용하는 llama.cpp) 및
- 오케스트레이션 계층(Ray Serve, Triton Inference Server, NVIDIA Dynamo).
오늘은 기존 방식 세 가지 진영에서 각각 하나씩, 그리고 하드웨어 최적화 옵션 중 가장 널리 사용되는 엔진을 비교해 보겠습니다. Together AI, Fireworks, Replicate와 같은 관리형 엔드포인트는 모델 호스팅을 담당하기 때문에 비교 대상에서 제외합니다. 따라서 서비스 엔진 관리는 해당 업체에서 책임져야 할 부분입니다. 또한 학습 프레임워크도 서비스 제공 이전 단계에서 다루어지기 때문에 비교 대상에서 제외합니다.
평가 체계.
서비스 제공 엔진을 선택할 때는 네 가지 요소를 고려해야 합니다.
- 동시 접속자 수에 따른 처리량 (동시 접속자 50~100명 이상일 때 초당 토큰 수)
- 설정부터 생산까지 소요 시간 (분~주)
- 하드웨어 유연성 (NVIDIA 전용 vs. 멀티 플랫폼)
- 작업 부하 적합성 (일괄 처리 vs. 다중 턴 채팅 vs. 구조화된 출력)
이 비교에 포함된 모든 도구는 네 가지 기준 모두에 따라 평가됩니다. 어떤 도구가 한 가지 기준에서 우수하면, 거의 항상 다른 기준에서는 불리해집니다. 이것이 바로 핵심입니다.
맞대결 분석
올라마
한 문장으로 요약하자면, LLM을 컴퓨터에서 바로 작동시킬 수 있는 가장 빠른 방법입니다.

👍 좋은 점:
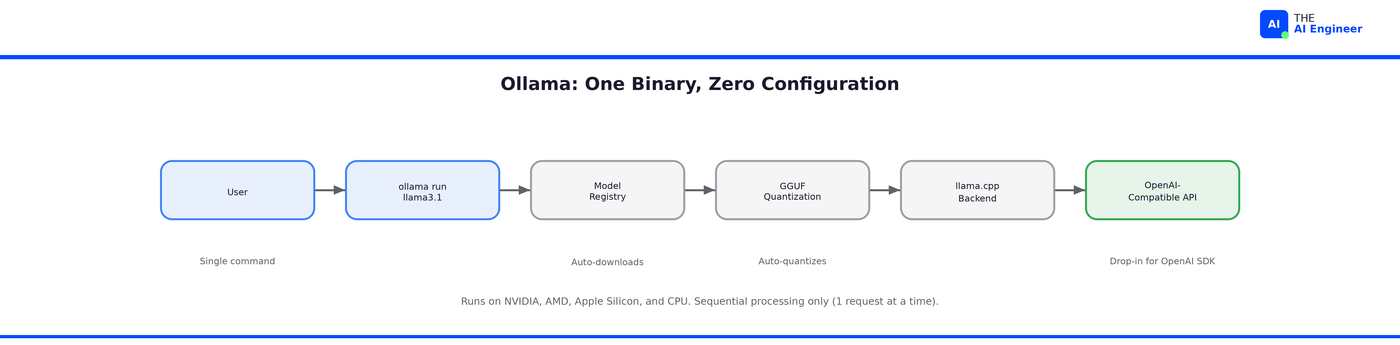
- 단 한 번의 명령으로 설정 가능합니다. 모델을 다운로드하고, 양자화하고, 제공합니다. Python 환경, CUDA 구성, Docker가 필요 없습니다. 10만 개 이상의 GitHub 스타와 월 5천2백만 건의 다운로드를 기록하며 , 압도적인 차이로 가장 널리 사용되는 로컬 LLM 런타임입니다. ollama run llama3.1
- 어디서든 잘 작동합니다. NVIDIA GPU, AMD GPU, Apple Silicon은 물론 CPU만으로도 실행됩니다. M4 Mac에서는 Qwen 2.5 32B를 초당 15토큰, MMLU 83.2%의 속도로 실행합니다. 이는 노트북에서 GPT-4 수준에 근접하는 성능입니다 .
- OpenAI 호환 API입니다. OpenAI SDK를 사용하는 모든 애플리케이션을 간편하게 대체할 수 있습니다. 하나의 환경 변수로 로컬 및 클라우드 환경을 전환할 수 있습니다.
- 한계 비용이 0입니다. 토큰당 가격 책정이 없습니다. 하드웨어를 소유하게 되면 추론은 무료입니다. 저는 RAG 프로젝트에서 Ollama를 사용하여 한 달 동안 신속한 반복 작업을 수행했는데, 비용에 대해 한 번도 생각해 본 적이 없습니다. 출력 토큰 백만 개당 10달러인 GPT-4o로 그렇게 해보세요.
👎 단점:
- 동시 요청 최적화 기능이 없습니다. Ollama는 배치 처리를 하지 않습니다. 세 명이 동시에 엔드포인트에 접속하면, 요청 2와 3은 요청 1이 완료될 때까지 대기해야 합니다. 동시 접속 사용자가 5명일 경우, p95 지연 시간은 이미 단일 사용자 지연 시간의 5배에 달합니다. 20명이 되면 사용자들은 로딩 스피너만 보게 될 것입니다 .
- 처리량 한계는 실제로 존재합니다. 벤치마크 결과에 따르면 Ollama는 사용자 수와 관계없이 초당 약 22개의 요청에서 정체되는 것으로 나타났습니다. 동일한 하드웨어에서 vLLM은 128개의 동시 요청에서 3.23배 더 많은 처리를 수행했습니다. 즉, 내부 도구가 "개인 테스트용"에서 "팀에서 매일 사용하는 도구"로 바뀌는 순간, 마이그레이션을 고려해야 한다는 의미입니다. 4
🎯 최적 사용 환경: 로컬 개발, 프로토타이핑, CI 파이프라인, 개인 정보 보호가 중요한 단일 사용자 애플리케이션, 엣지 배포.
🚧 한계: 동시 접속 사용자 수가 몇 명 이상이 되어야 하거나 부하 시 지연 시간이 중요한 경우 마이그레이션을 고려해야 합니다.
vLLM
한 문장으로 요약하자면, 대부분의 프로덕션 팀에서 가장 먼저 선택하는 엔진입니다. 핵심 기술인 PagedAttention은 GPU가 빈 슬롯에 메모리를 낭비하는 것을 방지하여 동일한 하드웨어에서 훨씬 더 많은 사용자를 처리할 수 있도록 합니다.

👍 좋은 점:
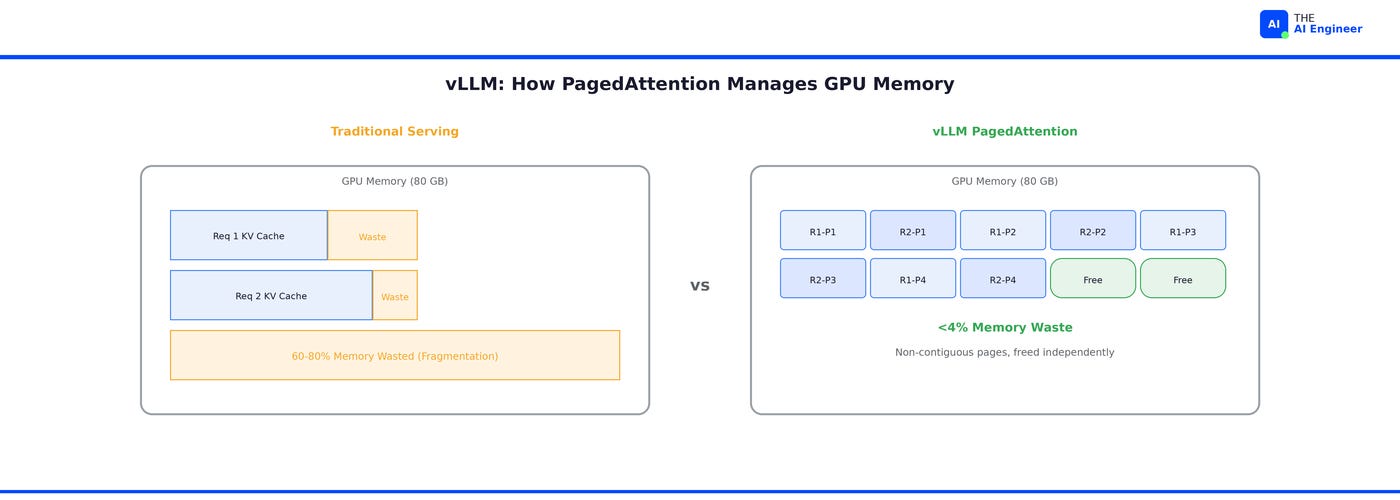
- PagedAttention은 GPU 메모리 사용 방식을 개선합니다. 기초 설명에서 언급했던 KV 캐시를 기억하시나요? 기존 엔진은 각 요청의 캐시를 위해 하나의 큰 연속된 메모리 블록을 예약합니다. 요청이 해당 블록을 모두 사용하지 않으면 남은 공간은 잠긴 채로 비어 있게 됩니다. 수많은 요청을 처리하다 보면 GPU 메모리의 60~80%가 이러한 빈 예약 공간에 낭비됩니다. vLLM은 운영 체제가 RAM을 관리하는 방식에서 아이디어를 가져왔습니다. 캐시를 작은 페이지로 나누어 각 페이지를 독립적으로 할당하고 해제하는 방식입니다. 더 이상 잠긴 빈 블록이 없습니다. 메모리 낭비율이 4% 미만으로 줄어들어 동일한 GPU로 훨씬 더 많은 동시 요청을 처리할 수 있습니다. 5
- 처리량 향상은 확실합니다. 2023년 최초 논문에서는 vLLM이 기존 HuggingFace Transformers보다 초당 최대 24배, TGI보다 3.5배 더 많은 요청을 처리할 수 있음을 보여주었습니다. 현재 벤치마크 결과에서도 이러한 격차가 여전히 유효함을 확인했습니다. 부하가 심한 상황(사용자 100명 이상)에서 vLLM은 GPU 사용률을 85~92%까지 유지하는 반면, TGI는 동일한 하드웨어에서 68~74%에 그칩니다. 즉, 유휴 상태인 GPU 사이클에 대한 비용을 지불하고 있는 셈입니다 .
- vLLM은 NVIDIA GPU, AMD GPU, Intel CPU 및 GPU, Google TPU, AWS Trainium, IBM Spyre, Huawei Ascend 등 모든 장치에서 실행됩니다 . 멀티 클라우드 환경을 사용하거나 클라우드 제공업체를 변경할 가능성이 있는 경우, vLLM은 코드 재작성을 강제하지 않는 유일한 엔진입니다.
- 거대한 생태계. OpenAI 호환 API를 기본적으로 제공합니다. 멀티 LoRA 서빙(재시작 없이 미세 조정된 어댑터 교체 가능). 투기적 디코딩(작은 모델이 토큰을 생성하고 큰 모델이 병렬로 검증하므로 생성 속도가 더 빠릅니다). v0.19.0에서는 버블이 없는 비동기 스케줄러가 출시되었고 Ray가 기본 종속성에서 제거되었습니다.
👎 단점:
- SGLang은 요청들이 동일한 컨텍스트를 공유할 때 vLLM보다 우수한 성능을 보입니다. 사용자들이 동일한 문서를 조회하거나 여러 차례에 걸쳐 대화를 나누는 경우, 많은 KV 캐시 데이터가 요청 간에 동일하게 유지됩니다. SGLang은 이러한 공유 캐시를 재사용합니다. vLLM은 그렇지 않거나, 적어도 SGLang만큼 적극적으로 재사용하지는 않습니다. H100 시스템에서 이러한 패턴이 나타날 때 SGLang은 29% 더 높은 처리량(초당 16,200개 토큰 대 12,500개 토큰)을 제공하고 출력 토큰 생성 속도도 2배 이상 빠릅니다 .
- 극한 부하 시 첫 응답 속도가 가장 느립니다. 동시 요청 100개일 때, vLLM의 최악의 경우 첫 토큰 생성 시간은 세 가지 운영 엔진 중 가장 깁니다. 8 사용자는 이를 알아차립니다. 즉, "전송" 버튼을 누른 후 첫 단어가 나타날 때까지의 지연입니다.
🎯 최적 사용 환경: 일반 프로덕션 서비스, 배치 처리, 다양한 하드웨어 환경, 광범위한 모델 호환성이 필요한 팀.
🚧 한계점: 트래픽의 대부분이 사용자들이 채팅을 주고받거나 동일한 문서를 반복적으로 조회하는 경우, SGLang은 공유 컨텍스트에서 계산을 재사용하기 때문에 더 빠르게 처리할 수 있습니다. 반면 vLLM은 매번 계산을 새로 수행합니다. 이러한 패턴이 트래픽의 대부분을 차지하게 되면, SGLang이 완전히 건너뛸 수 있는 GPU 작업에 대한 비용을 지불하게 됩니다.
API 뒤에 첫 모델을 배포하려는 엔지니어를 알고 계신가요? 그들이 아직 겪어보지 못한 OOM(메모리 부족) 오류가 발생할 수 있습니다. 이 정보를 공유해 주세요.
SGLang
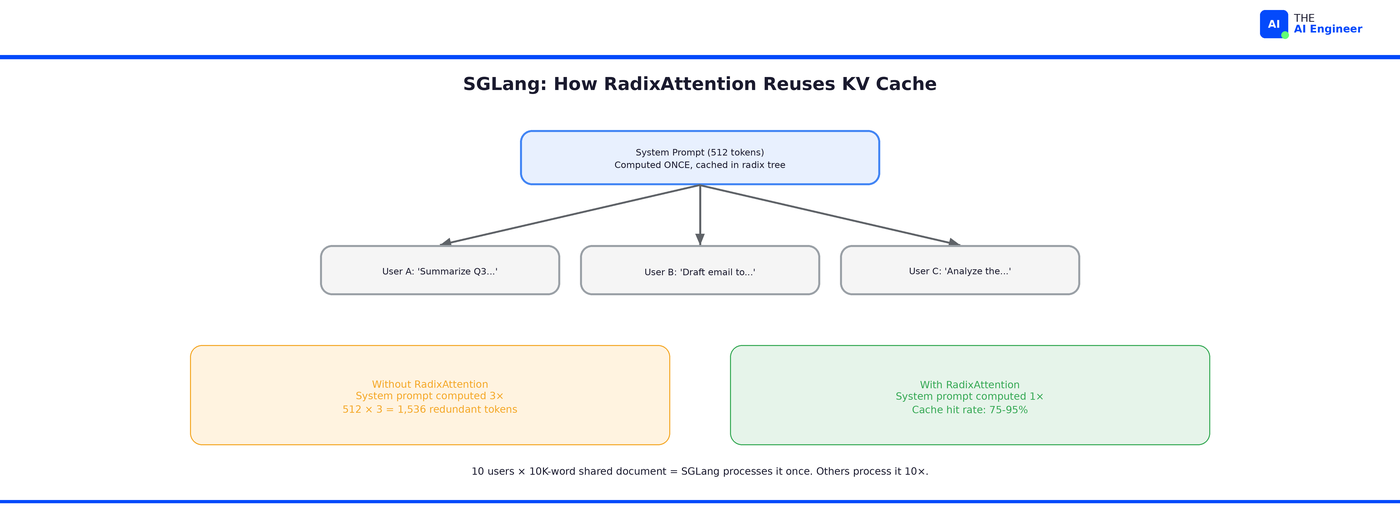
한 문장으로 요약하자면, SGLang은 이미 수행한 작업을 기억하는 엔진입니다. 여러 요청이 동일한 컨텍스트를 공유하는 경우, SGLang은 계산을 다시 수행하는 대신 기존 계산을 재사용하여 최대 6.4배의 처리량 향상을 제공합니다.
👍 좋은 점:
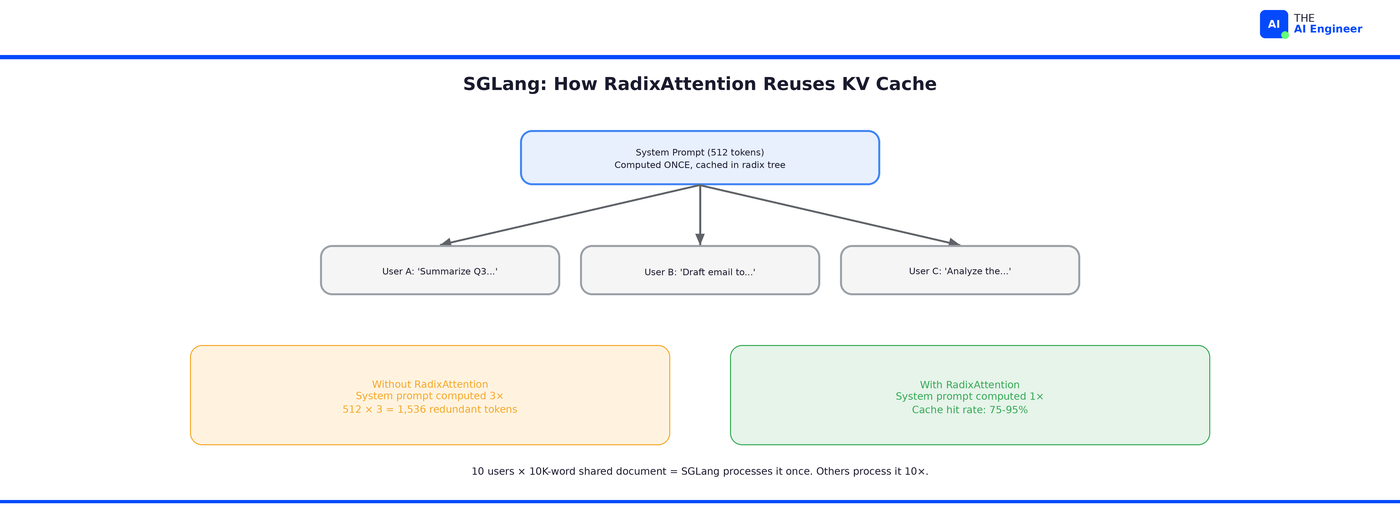
- RadixAttention은 요청 간에 작업을 재사용합니다. 대부분의 엔진은 각 요청이 완료된 후 키-값 캐시를 버립니다. SGLang은 이를 기수 트리(자동 완성 인덱스와 같이 공유 접두사를 찾는 데 최적화된 데이터 구조)에 유지합니다. 새 요청이 이전 요청과 동일한 토큰(동일한 시스템 프롬프트, 동일한 문서, 동일한 대화 기록)으로 시작하는 경우 SGLang은 해당 토큰을 다시 계산하는 작업을 완전히 건너뜁니다. 10명의 사용자가 동일한 10,000단어 문서(일반적인 RAG 패턴)를 조회하는 경우 SGLang은 해당 문서를 한 번만 처리합니다. 다른 엔진은 이를 10번 처리합니다. 9
- 캐시 재사용은 실제로 효과적입니다. 소량 데이터 학습(few-shot learning)에서는 85~95%의 캐시 재사용률을 달성합니다. 다중 턴 채팅에서는 75~90%, 모든 요청에 동일한 도구 정의가 포함되는 에이전트 기반 워크플로우 에서는 75~95%의 캐시 재사용률을 보입니다. 이는 대부분의 계산이 완전히 생략된다는 것을 의미합니다 .
- 구조화된 출력 속도가 3배 빨라졌습니다. 모델이 유효한 JSON 또는 XML을 출력해야 할 때, 대부분의 엔진은 토큰 단위로 규정 준수 여부를 확인하는데, 이로 인해 생성 속도가 느려집니다. SGLang은 압축된 유한 상태 머신 (기본적으로 모든 유효한 다음 토큰의 사전 구축된 맵)을 사용하고, 모델 자체의 계산과 병렬로 해당 검사를 실행합니다. JSON 규정 준수율은 속도 저하 없이 90~94%에서 96~98.2%로 향상됩니다.
- 대규모 환경에서 실전 검증을 거쳤습니다. SGLang은 실제 운영 환경에서 40만 개 이상의 GPU에서 실행됩니다. xAI의 Grok, Microsoft Azure 엔드포인트, LinkedIn의 AI 기능, Cursor의 코드 완성 기능, Oracle Cloud 등에서 사용되고 있습니다. 12
👎 단점:
- 공유된 컨텍스트가 없으면 이점도 없습니다. 모든 프롬프트가 다를 경우(일괄 콘텐츠 생성, 일회성 분류) 재사용할 것이 없습니다. 단일 턴 고유 프롬프트에 대한 테스트에서 vLLM은 실제로 SGLang보다 우수한 성능을 보였습니다(60 tok/s 대 52.7 tok/s). 이 마법은 요청이 겹칠 때만 작동합니다. 13
- vLLM보다 생태계 규모가 작습니다. vLLM은 기여자 수가 3배 더 많습니다. SGLang은 지원하는 모델 아키텍처 수가 더 적지만(Llama, Qwen, DeepSeek, Gemma, Mistral 및 멀티모달 모델 등 주요 아키텍처는 모두 포함함)
🎯 최적 사용 환경: 다중 턴 챗봇, RAG 파이프라인, 에이전트 기반 워크플로, 구조화된 JSON 출력, DeepSeek 배포.
🚧 한계: 모든 프롬프트가 고유하고 반복되지 않는 배치 처리를 실행하는 경우, vLLM의 더 넓은 생태계와 동등한 성능이 더 나은 선택이 될 수 있습니다. SGLang의 가장 큰 장점은 접두사 재사용입니다. 공유 접두사가 없으면 SGLang은 그저 또 다른 빠른 엔진일 뿐입니다.
텐서RT-LLM
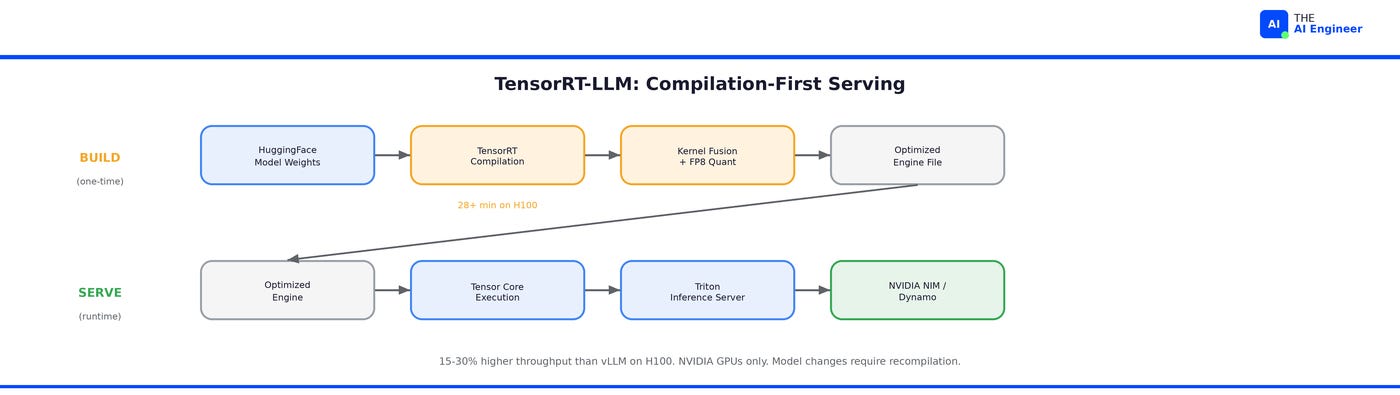
한 문장으로 요약하자면, NVIDIA는 이 엔진을 자사 GPU에 맞춰 특별히 개발했습니다. 하드웨어별 최적화를 통해 성능을 최대한 끌어내지만, NVIDIA 그래픽 카드에서만 작동하며 설정하는 데 상당한 노력이 필요합니다.
👍 좋은 점:
- NVIDIA 하드웨어에서 가장 빠릅니다. H100에서 vLLM보다 처리량이 15~30% 더 높습니다. 예측 디코딩(작은 모델이 다음 토큰 몇 개를 예측하고 큰 모델이 하나씩이 아닌 한꺼번에 검증하는 방식)을 지원하여 최대 3.6배 빠른 토큰 생성 속도를 제공합니다. 최신 Blackwell GPU에서 TensorRT-LLM은 Llama 4 Maverick에서 사용자당 초당 1,000개의 토큰을 처리합니다 .
- NVIDIA의 모든 스택과 완벽하게 통합됩니다. 조직에서 이미 Triton Inference Server(모델 제공), NVIDIA NIM(사전 패키지 모델 컨테이너) 또는 NVIDIA Dynamo(GPU 간 작업 분산)를 사용하고 있다면 TensorRT-LLM은 이러한 모든 기능에 기본적으로 연결됩니다.
- 하드웨어를 실제로 활용하는 내장 양자화 기능. FP8, INT8, FP4 양자화(모델 가중치의 정밀도를 낮춰 메모리를 절약하고 연산 속도를 향상시키는 방식)가 NVIDIA의 Tensor Core에 최적화되어 내장되어 있습니다. 일반 소비자용 RTX 4090에서 TensorRT-LLM은 llama.cpp보다 70% 더 빠른 속도로 실행되었는데, 이는 다른 엔진들이 부분적으로 유휴 상태로 남겨두는 512개의 Tensor Core와 1,000GB/s의 메모리 대역폭을 TensorRT-LLM이 완벽하게 활용할 수 있었기 때문입니다. 15
- (v0.19부터) PyTorch 네이티브 아키텍처를 지원합니다 . 더 이상 PyTorch 백엔드를 위한 별도의 빌드 단계가 필요하지 않습니다. 다른 PyTorch 프로젝트처럼 코드를 읽고 수정할 수 있습니다.
👎 단점:
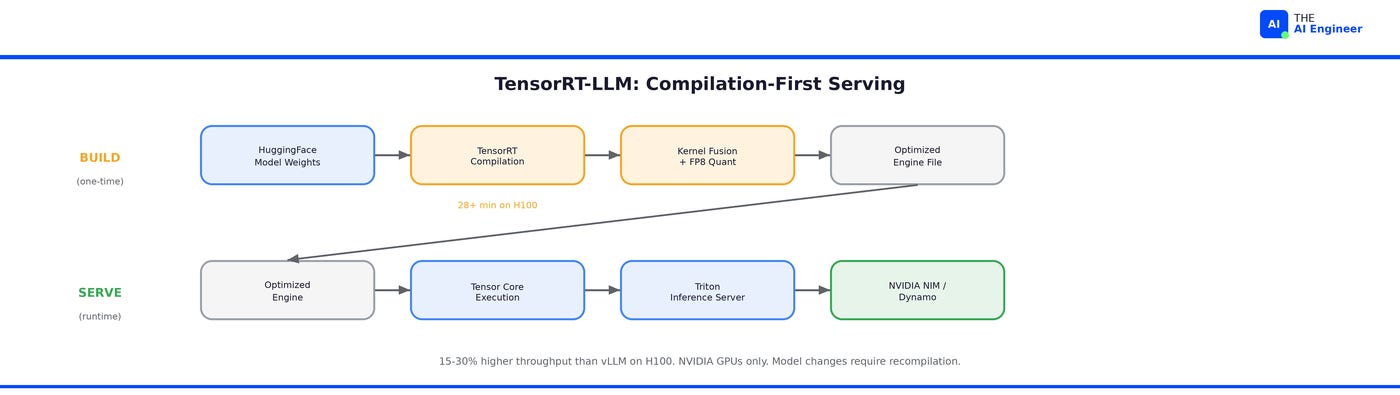
- 먼저 모델을 컴파일해야 합니다. TensorRT-LLM은 단일 요청을 처리하기 전에 특정 GPU에 맞게 모델을 컴파일하고 최적화해야 합니다. H100 GPU에서는 이 작업에 28분 이상이 소요됩니다. 모델을 교체하거나 가중치를 업데이트할 때마다 다시 컴파일해야 합니다. 매주 업데이트를 진행한다면 주기당 반나절이 손실되는 셈입니다. 16
- NVIDIA GPU만 지원합니다. AMD GPU, Apple Silicon, TPU는 지원하지 않습니다. 혼합 인프라를 운영하거나 클라우드 제공업체를 변경할 가능성이 있는 경우, 이 제품을 도입하는 순간부터 특정 NVIDIA 칩셋에 종속됩니다.
- 학습 곡선이 가파릅니다. "Hello World"를 실행하는 데부터 실제 운영 환경까지 도달하는 데 전문가 1~2주가 소요됩니다. 문서에서는 사용자가 Triton, NeMo, CUDA를 이미 알고 있다고 가정합니다. 만약 이러한 용어들이 생소하다면, 학습 기간을 고려하여 예산을 계획하십시오.
🎯 최적의 용도: NVIDIA 하드웨어 기반의 장기적인 프로덕션 환경에서 안정적인 단일 모델로 수백만 건의 요청을 처리하고, 처리량 향상이 초기 설정 비용을 상쇄할 만큼 중요한 경우.
🚧 한계점: 모델을 자주 교체하거나, NVIDIA가 아닌 하드웨어에서 실행하거나, 하루 만에 초기 개발 단계에서 상용화 단계로 넘어가야 하는 경우, 컴파일 오버헤드와 벤더 종속성 때문에 TensorRT-LLM은 적합하지 않습니다. TensorRT-LLM은 전문가용 도구입니다. 대부분의 팀에는 전문가가 필요하지 않습니다.
TGI에 무슨 일이 있었던 걸까요?
HuggingFace의 텍스트 생성 추론(TGI)은 이 분야를 개척했습니다. 널리 채택된 최초의 서비스 엔진이었으며, HuggingChat과 HuggingFace 추론 엔드포인트를 구동하고 업계가 최적화된 트랜스포머 아키텍처를 향해 나아가도록 이끌었습니다. 하지만 2026년을 기점으로 HuggingFace는 TGI를 공식적으로 유지보수 모드로 전환했습니다. GitHub README에는 "앞으로 사소한 버그 수정, 문서 개선 및 간단한 유지보수 작업에 대한 풀 리퀘스트만 수락할 예정입니다."라고 명시되어 있으며, 대신 vLLM, SGLang 및 llama.cpp를 사용할 것을 권장하고 있습니다. 17
현재 운영 환경에서 TGI를 사용하고 있다면 계속 사용할 수 있습니다. 하지만 새로운 기능, 성능 향상 및 모델 지원은 vLLM 및 SGLang에 먼저 제공될 예정입니다. 마이그레이션 계획을 세우십시오.
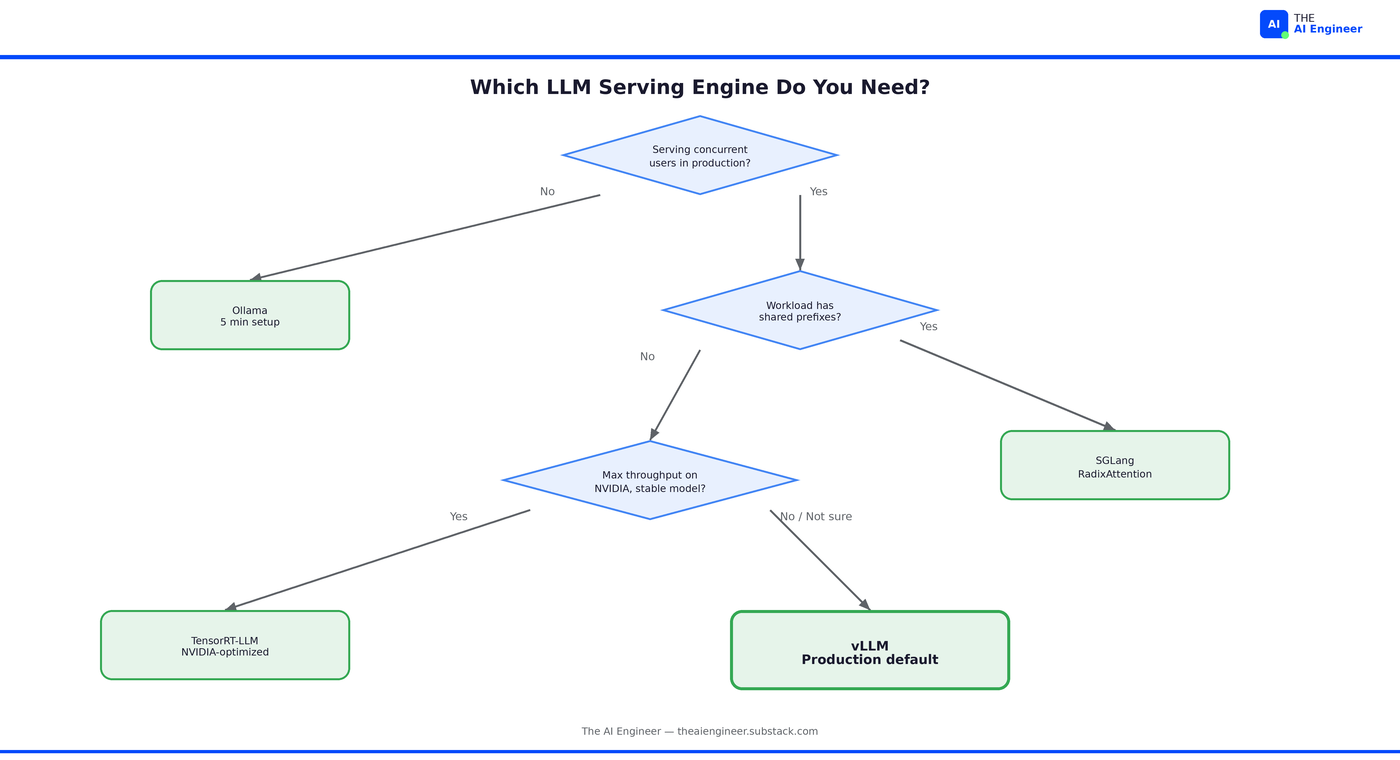
의사결정 흐름도
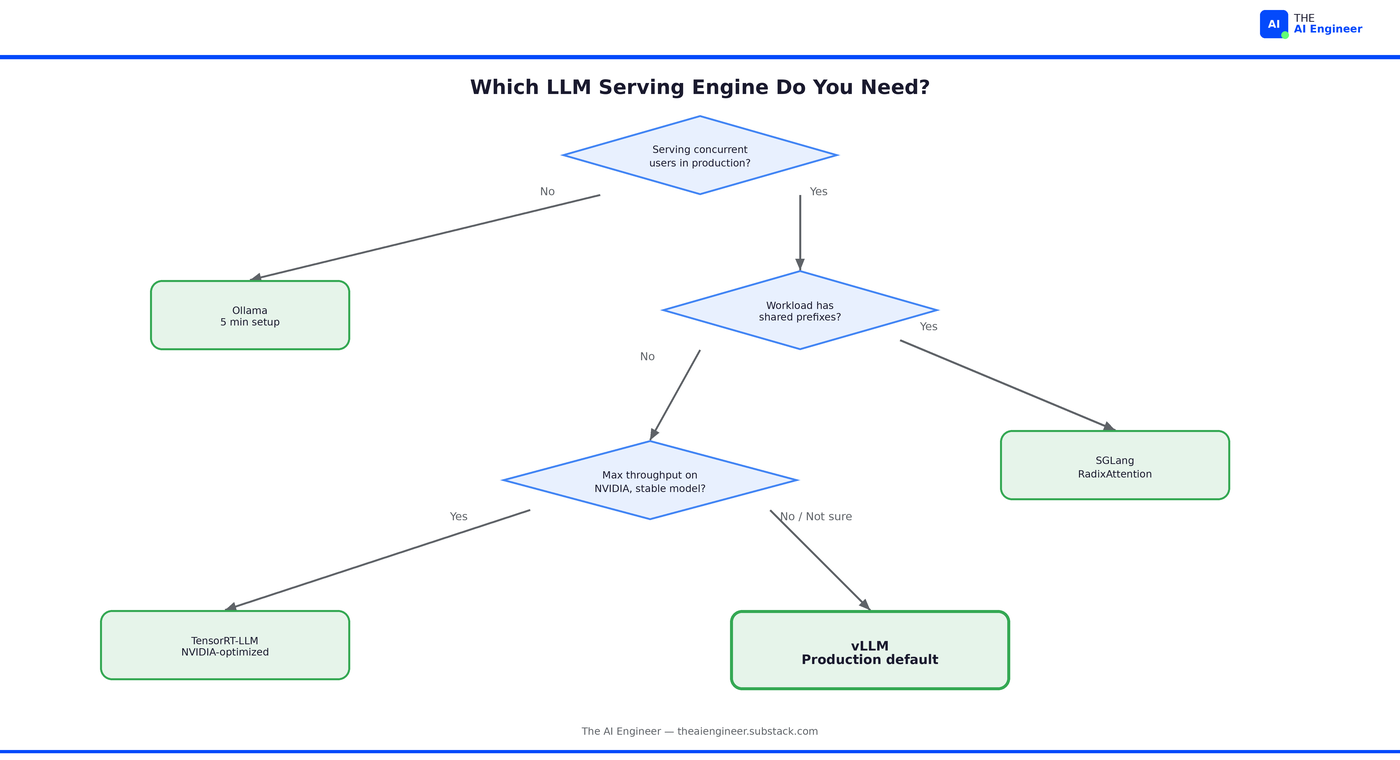
논리 (네 가지 평가 요소에 적용):
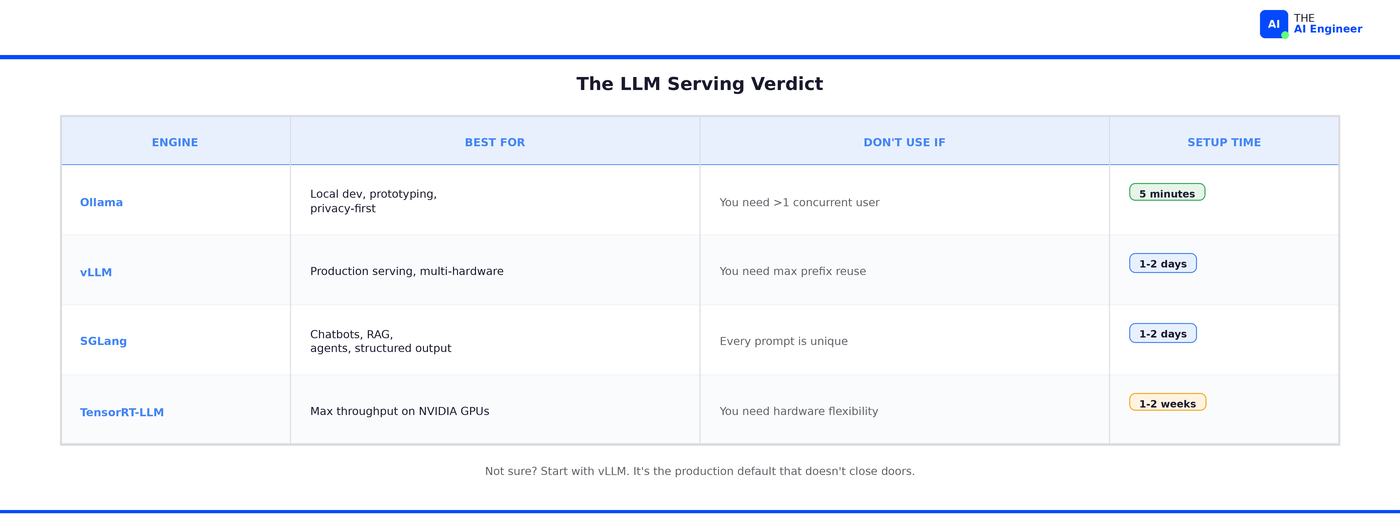
- 설정 시간이 구매 결정에 가장 큰 영향을 미치나요? 아직 동시 접속 사용자를 처리하지 못하고 있나요? 올라마(Ollama)를 사용해 보세요. 단 5분 만에 기본 모델을 구축하고 바로 사용할 수 있습니다. 이보다 빠른 제품은 없습니다.
- 워크로드 적합성이 가장 중요한가요? 사용자들이 비슷한 맥락을 공유하는 요청을 많이 보내나요? (채팅을 주고받거나, 같은 문서를 조회하거나, 모든 통화에서 같은 지침을 전달하는 상담원 등) 그렇다면 SGLang을 사용하세요. SGLang 은 공유되는 맥락을 캐시하여 재계산을 건너뜁니다. 모든 요청이 고유하고 반복되는 내용이 없다면 vLLM으로 넘어가세요.
- 처리량이 가장 중요하신가요? NVIDIA에서 최고 성능을 내는 것이 최우선이고, 모델이 몇 달 동안 변경되지 않을 예정이신가요? 그렇다면 TensorRT-LLM을 사용하세요. 컴파일 비용과 벤더 종속성을 감수하더라도 vLLM 대비 15~30%의 성능 향상을 얻을 수 있습니다.
- 하드웨어 유연성이 가장 중요하신가요? 멀티 클라우드 환경을 구축하고 싶거나, NVIDIA 그래픽 카드를 사용하지 않거나, 특정 벤더에 종속되고 싶지 않으신가요? 그렇다면 vLLM이 정답입니다. vLLM은 모든 플랫폼에서 실행되고 모든 기능을 충분히 잘 수행합니다. vLLM은 선택의 폭을 넓혀주는 최적의 솔루션입니다.
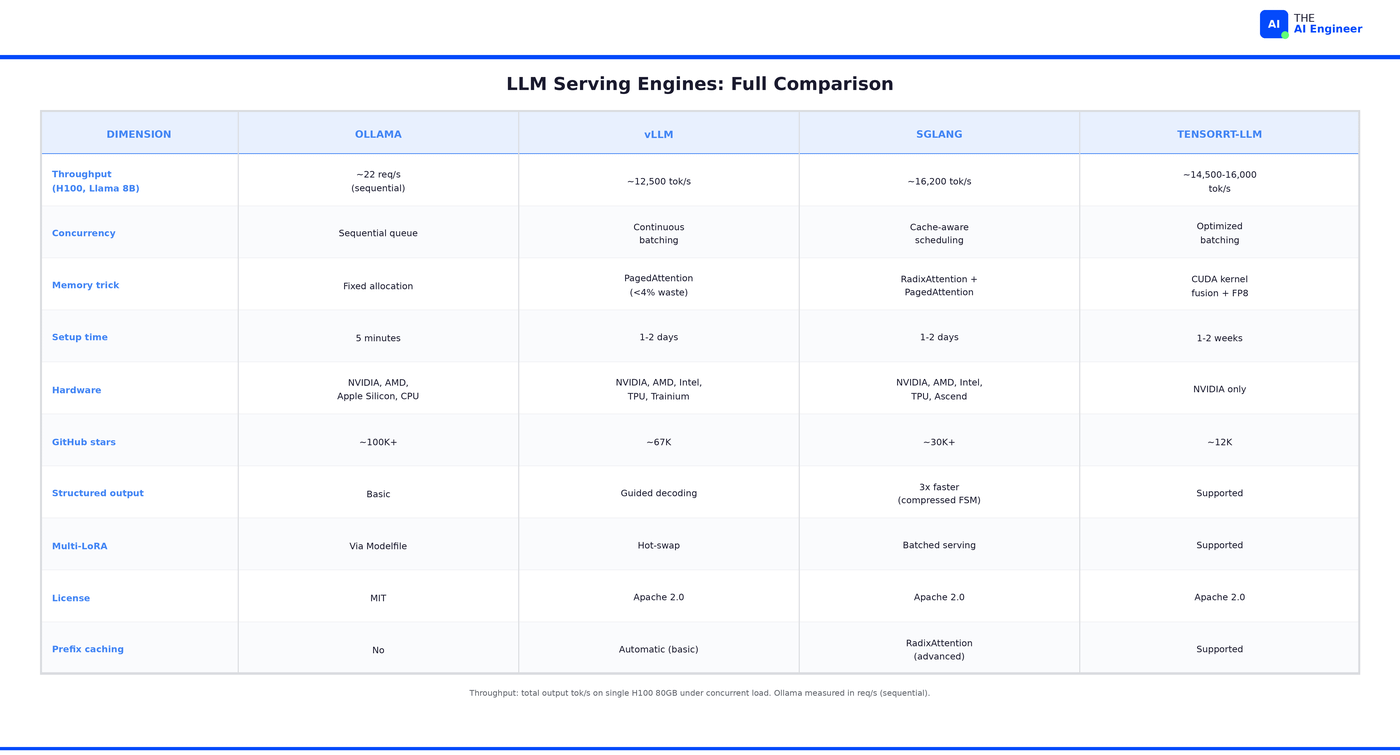
비교표
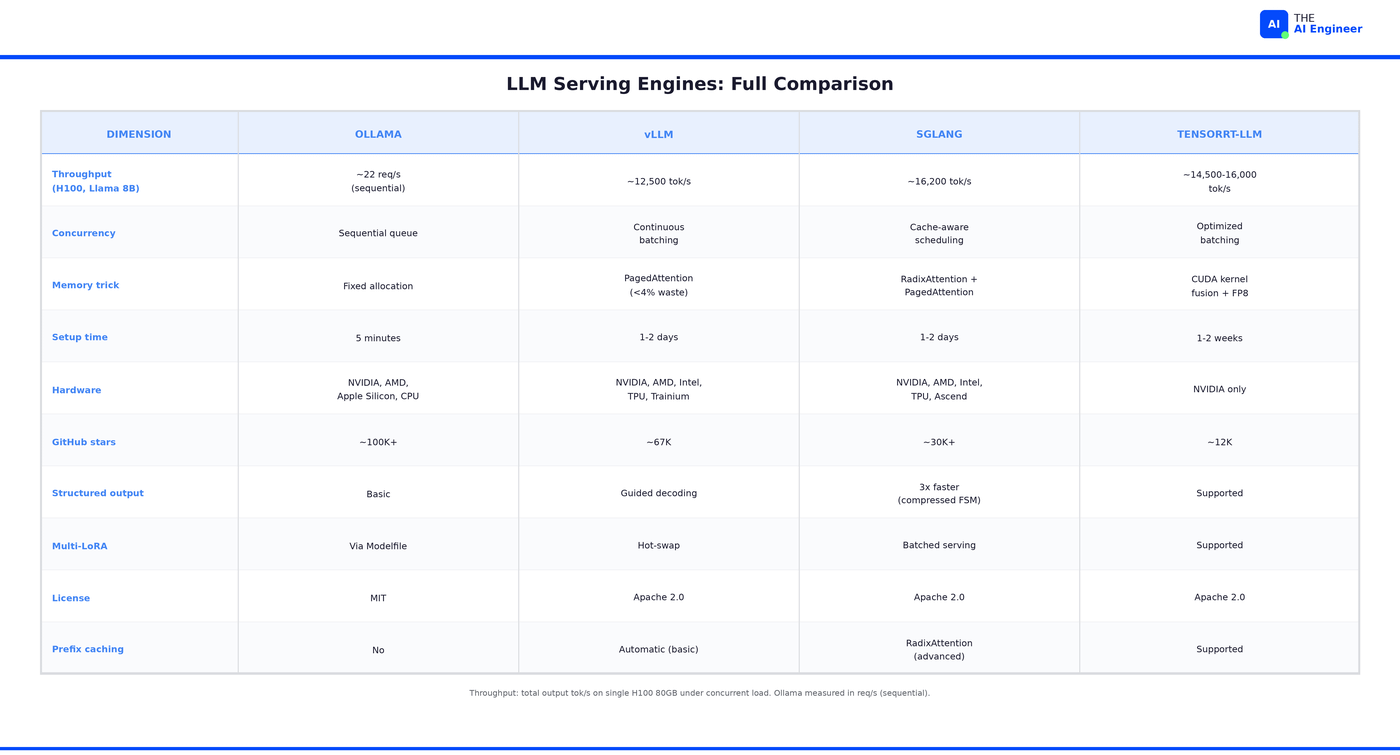
참고 : vLLM, SGLang 및 TensorRT-LLM의 처리량 수치는 단일 H100 80GB 서버에서 동시 부하 시 초당 총 출력 토큰 수를 나타냅니다. Ollama는 순차적으로 처리하기 때문에 초당 요청 수를 나타냅니다. 이러한 범주 간의 직접 비교는 의도적으로 서로 다른 두 가지를 비교하는 것이며, 이것이 바로 이러한 결정의 핵심입니다.
🔎 심층 분석: Spheron은 Llama 3.3 70B 명령어를 FP8 정밀도로 실행하여 동일한 H100 SXM5 80GB 칩셋에서 세 가지 양산 엔진을 모두 구동했습니다. 전체 벤치마크에는 TTFT, 출력 처리량 및 VRAM 측정값이 포함됩니다.
하이브리드 접근법
많은 팀에서 두 개 이상의 엔진을 사용합니다. 가장 일반적인 패턴은 개발에는 Ollama를, 프로덕션에는 vLLM 또는 SGLang을 사용하는 것입니다. 이 세 가지 엔진 모두 OpenAI와 호환되는 API를 제공하기 때문에 이러한 방식이 가능합니다. 애플리케이션 코드는 그대로 유지되며, 엔드포인트 URL만 변경됩니다.
# Same code. Different engine. Swap by changing one line.
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",  # Ollama (dev)
    # base_url="http://localhost:8000/v1",  # vLLM (staging)
    # base_url="http://localhost:30000/v1", # SGLang (production)
    api_key="not-needed"
)

response = client.chat.completions.create(
    model="llama3.1",
    messages=[{"role": "user", "content": "Explain KV caching in one paragraph."}]
)
저는 RAG 프로토타입에서 이와 똑같은 마이그레이션 경로를 실행해 봤습니다. MacBook에서 Ollama를 사용하여 2주 동안 신속한 반복 작업을 진행한 후, 데모를 내부적으로 배포하게 되면서 단 하루 오후 만에 기본 URL을 vLLM 클러스터로 변경했습니다. 애플리케이션 코드 변경은 전혀 없었습니다.
규모가 큰 조직의 경우, 사용자 대상 챗봇에는 SGLang을, 접두사 재사용으로 GPU 자원을 절약할 수 있는 RAG에는 vLLM을, 배치 처리 작업에는 vLLM을 사용하는 것이 좋습니다. 동일한 모델을 사용하지만 트래픽 패턴에 맞춰 엔진을 선택할 수 있습니다.
솔직한 평가
잠시 현실적으로 생각해 봅시다. 서비스 엔진을 선택하기 전에, 과연 서비스 엔진이 필요한지부터 자문해 보세요. 130억 개 미만의 파라미터를 가진 모델에 10명 미만의 동시 접속 사용자만 서비스를 제공한다면, 괜찮은 GPU를 사용하는 Ollama로도 충분합니다. 어차피 GPT-4o나 Claude 같은 모델을 사용하고 특정 작업에만 오픈 소스 모델이 필요한 경우라면, Together AI나 Fireworks의 관리형 엔드포인트를 사용하는 것이 vLLM을 구성하는 데 드는 엔지니어링 시간보다 비용이 적게 듭니다.
셀프 호스팅에 대한 기대감은 크지만, 운영 비용 또한 만만치 않습니다 . vLLM 클러스터를 운영한다는 것은 GPU 프로비저닝, 모델 업데이트, 모니터링, 장애 조치 등을 모두 직접 관리해야 한다는 의미입니다. 이는 주말에 잠깐 할 수 있는 프로젝트가 아니라, 팀 차원의 작업이 필요합니다.
진정한 의미에서 자체 호스팅이 필요한 팀(지연 시간에 민감한 애플리케이션, 데이터 주권 요구 사항, 일일 10만 건 이상의 요청 처리 시 비용 최적화 등)의 경우, 이 분야는 빠르게 통합되고 있습니다. 1년 전만 해도 TGI가 최고의 경쟁자였지만, 지금은 유지보수 모드에 들어갔습니다. 살아남은 엔진들은 특정하고 어려운 문제를 해결하는 엔진들입니다. PagedAttention(vLLM), RadixAttention(SGLang), 그리고 심층적인 하드웨어 최적화(TensorRT-LLM) 등이 그 예입니다. Ollama는 개발자 경험을 바탕으로 살아남았는데, 이는 모방하기 가장 어려운 요소입니다.
제가 가장 흔히 보는 실수는 모델 최적화 전에 서비스 엔진을 최적화하는 것입니다. 가장 빠른 엔진에서 양자화가 제대로 되지 않은 모델은 여전히 느립니다. 반면 Ollama에서 양자화가 잘 된 모델은 대부분의 사용 사례를 처리합니다. 엔진 선택 자체보다 엔진을 사용하기 전에 수행하는 작업, 즉 양자화 전략, 프롬프트 길이 관리, 컨텍스트 윈도우 크기 조정이 훨씬 더 중요합니다.
대부분의 시동 실패는 엔진 문제가 아니라 사용자 실수에서 비롯됩니다. 모델 준비를 먼저 완벽하게 하세요.
운영 환경에서 사용 중인 서버 엔진이 무엇인가요? 답글을 남겨주시고, 기존에 사용하던 엔진과 새로 도입한 엔진을 알려주세요.
다음 목적지는 어디인가요?
🔬 더 자세히 알아보기: 양자화란 무엇일까요? (출시 예정)에서는 네 가지 엔진 모두를 실제 하드웨어에서 구현 가능하게 만드는 기술에 대해 다룹니다. 양자화가 없으면 70B 모델은 140GB의 VRAM이 필요하지만, 양자화를 사용하면 단일 GPU에서도 실행 가능합니다.
📗 더 간단하게: 추론이 느리고 비용이 많이 드는 이유는 무엇일까요? (출시 예정)에서는 이러한 엔진이 해결해야 할 근본적인 병목 현상, 즉 키-값 캐시 증가, 자기회귀 디코딩 및 메모리 대역폭에 대해 설명합니다.
🔀 관련 기사: NVIDIA는 실제로 무엇을 할까요? 이 기사에서는 이 네 가지 엔진 중 세 가지가 최적화된 하드웨어를 제공하는 회사인 NVIDIA에 대해 다룹니다.
API 뒤에 첫 모델을 배포하려는 엔지니어를 알고 계신가요? 그들이 아직 겪어보지 못한 OOM(메모리 부족) 오류가 발생할 수 있습니다. 이 정보를 공유해 주세요.
2Pooya Golchian, 2026년 로컬 AI: Ollama 벤치마크, $0 추론 .
3SitePoint, Ollama 및 vLLM: 성능 벤치마크 2026
4로버트 맥더모트, 성능 대 실용성: vLLM과 Ollama의 비교 .
5권 등, PagedAttention을 사용하는 대규모 언어 모델 서비스용 효율적인 메모리 관리 (SOSP 2023).
6LLM 추론 서비스 시스템의 비교 분석 (2025).
9Zheng et al., SGLang: 구조화된 언어 모델 프로그램의 효율적인 실행 (2024).
11Zheng et al., SGLang: 구조화된 언어 모델 프로그램의 효율적인 실행 (2024).
14NVIDIA, Blackwell, 1,000 TPS/사용자 장벽 돌파(2026) .
15Jan.ai, NVIDIA TensorRT-LLM 벤치마킹 .
vLLM, TensorRT-LLM, SGLang: 어느 것이 가장 빠를까? (H100 벤치마크, 2026)
vllm vs sglangsglang vs vllmvllm tensorrt-llm sglang 비교vllm vs tensorrt추론 엔진 벤치마크vLLM텐서RT-LLMSGLangLLM 추론H100추론 최적화TTFT콜드 스타트 시간최대 VRAM 사용량
vLLM, TensorRT-LLM, SGLang: 어느 것이 가장 빠를까? (H100 벤치마크, 2026)
블로그로 돌아가기
Spheron 공동 창립자 겸 CTO 인 Mitrasish 가 작성함
2026년 3월 23일 발행
업데이트됨 2026년 8월 19일
vllm vs sglang
sglang vs vllm
vllm tensorrt-llm sglang 비교
vllm vs tensorrt
추론 엔진 벤치마크
vLLM
텐서RT-LLM
SGLang
LLM 추론
H100
추론 최적화
TTFT
콜드 스타트 시간
최대 VRAM 사용량
vLLM, TensorRT-LLM, SGLang: 어느 것이 가장 빠를까? (H100 벤치마크, 2026)
엑스
불화
링크드인
공유하다
모델을 선택하셨다면 이제 어떻게 제공할지 결정해야 합니다. vLLM, TensorRT-LLM, SGLang은 2026년 프로덕션 LLM 추론에 중요한 세 가지 엔진이며, 각각 매우 다른 장단점을 가지고 있습니다. 저희는 동일한 H100 80GB GPU에서 Llama 3.3 70B 명령어를 FP8 정밀도로 실행했습니다. 실제 결과는 다음과 같습니다. 이미 vLLM을 프로덕션 환경에서 사용하고 있고 멀티 GPU 배포 가이드가 필요하시면 vLLM 멀티 GPU 프로덕션 배포 2026을 참조하세요 . 세 가지 프레임워크의 배포 가이드는 Spheron의 LLM 빠른 가이드 에서 확인할 수 있습니다 . MLPerf Inference v6.0에는 GPT-OSS 120B 태스크를 사용한 표준화된 LLM 벤치마크가 추가되었습니다. 최신 점수는 MLPerf v6.0 분석에서 확인하세요. 주로 Hugging Face Hub 게이트 모델을 사용하고 네이티브 GPTQ/AWQ 체크포인트 지원이 필요한 경우, Hugging Face TGI 프로덕션 배포 가이드 에서 TGI를 네 번째 옵션으로 검토해 볼 것을 권장합니다. Modular MAX는 그래프 컴파일된 Mojo 커널을 통해 높은 동시성 환경에서 밀집 모델에 대해 vLLM보다 우수한 성능을 보여주며 다섯 번째 경쟁자로 떠오르고 있습니다. H100 벤치마크 결과는 Modular MAX vs vLLM 배포 가이드를 참조하십시오 . RadixAttention 접두사 재사용과 PagedAttention KV 페이징 메커니즘에 초점을 맞춘 심층적인 비교는 vLLM vs SGLang 2026 벤치마크 가이드 에서 확인할 수 있으며, 여기에는 접두사 사용량이 많은 TTFT 벤치마크(본 가이드에서는 측정하지 않음)를 포함하여 두 엔진을 자세히 다룹니다. TensorRT-LLM 컴파일 엔진과 vLLM 중 어떤 것을 선택할지 고민 중이고 SGLang은 고려 대상이 아니라면, H100 데이터 에서 vLLM과 TensorRT-LLM의 토큰당 비용 분석을 통해 두 가지 엔진만 추려낼 수 있습니다. 커뮤니티 양자화 체크포인트(EXL2, GPTQ 또는 GGUF 형식)를 사용하거나 채팅 제품에 DRY 및 XTC와 같은 고급 샘플러가 필요한 경우, Aphrodite Engine도 고려해 볼 만한 네 번째 옵션입니다. 최근 등장한 TokenSpeed는 에이전트 코딩 워크로드에서 B200 벤치마크를 통해 TensorRT-LLM보다 지연 시간은 9%, 처리량은 11% 우위를 보이므로 자체 비교 테스트에 추가해 볼 가치가 있습니다. 이러한 엔진들을 Docker 환경이 아닌 Kubernetes 네이티브 CRD 뒤에 배포하는 경우, KServe, Seldon Core 및 BentoML 비교를 통해 해당 엔진 위에 있는 운영자 계층에 대한 정보를 얻을 수 있습니다.
요약
엔진 가장 적합한 대상 처리량(50개 필요) TTFT p50 (10개 필요) 콜드 스타트
vLLM 일반적인 용도, 광범위한 모델 지원 1,850 토크/초 120밀리초 약 62초
텐서RT-LLM 최대 처리량, 고정 모델 2,100 토크/초 105밀리초 약 28분
SGLang 공유 접두사 워크로드, 낮은 지연 시간 1,920 토크/초 112밀리초 약 58초
가장 빠른 제품 출시와 모델 업데이트 유연성을 원한다면 vLLM을 사용하십시오 .
장기간 운영 환경에서 단일 모델을 사용하고 처리량이 가장 중요한 경우 TensorRT-LLM을 사용하십시오 .
워크로드에 공유 접두사(챗봇, RAG 파이프라인, 다중 턴 대화)가 있는 경우 SGLang을 사용하십시오 .
테스트 설정
하드웨어
모든 벤치마크는 온디맨드 요금제( 현재 가격 참조)로 제공되는 단일 Spheron H100 SXM5 80GB 인스턴스 에서 실행되었습니다 . 해당 인스턴스는 하이퍼바이저 오버헤드 없이 베어메탈에서 실행됩니다. 호스트 드라이버는 590.48.01(현재 안정 버전 R590)입니다. vLLM 및 SGLang은 CUDA 13.0(cu130) 컨테이너에서 실행되고, TensorRT-LLM v1.2.0은 CUDA 13.1.0(pytorch:25.12-py3)을 사용합니다. 세 가지 컨테이너 모두 드라이버 590에서 호환성 shim 없이 실행됩니다. NVLink는 존재하지만 단일 GPU 실행에는 사용되지 않습니다. Hopper, Blackwell 및 Ada Lovelace의 다른 GPU 옵션은 전체 GPU 렌탈 카탈로그를 참조하십시오 .
모델
FP8 정밀도를 사용했습니다 meta-llama/Llama-3.3-70B-Instruct. Llama 3.3은 가장 널리 배포된 70B 명령어 추종 밀집 모델이며 추론 엔진 비교를 위한 표준 벤치마크 대상으로 사용됩니다. Llama 4(2025년 4월 출시)는 단일 GPU 메모리 특성이 다른 혼합형 전문가 아키텍처를 사용합니다. Spheron에서의 Llama 4 배포에 대한 자세한 내용은 Llama 4 Scout 및 Maverick 가이드를 참조하십시오 . Llama 3.3 설정에 대한 자세한 내용은 Spheron의 Llama 3 가이드를 참조하십시오 . FP8에서 70B 가중치는 약 70GB를 차지하며, 신중한 튜닝을 통해 80GB H100에 적합합니다. 세 가지 프레임워크 모두 네이티브 FP8 양자화를 사용합니다. vLLM은 --quantization fp8(로드 시 온라인 동적 양자화), SGLang은 --quantization fp8, TensorRT-LLM은 --qformat fp8컴파일 전 quantize.py 단계에서 양자화를 사용하며, 이 모든 기능은 CUDA 12.0부터 H100에서 완벽하게 지원됩니다.
프레임워크 버전:
vLLM v0.18.0
TensorRT-LLM v1.2.0
SGLang v0.5.9
벤치마킹 방법론
우리는 비동기 Python 클라이언트를 사용하여 aiohttp부하를 생성했습니다. 각 실행은 다양한 명령어 데이터셋에서 추출한 200개의 프롬프트를 사용했으며, 평균 입력 길이는 512 토큰, 평균 출력 길이는 256 토큰이었습니다(재현성을 위해 시드 값은 42로 고정). 동시 요청 수는 1, 10, 50, 100의 네 가지 수준으로 설정하여 테스트를 진행했습니다. 각 동시 요청 수준은 60초의 워밍업 후 3분 동안 실행되었습니다. VRAM은 nvidia-smi --query-gpu=memory.used1초 간격으로 샘플링했으며, 피크 값은 측정 기간 동안 기록된 최대값입니다.
벤치마크 결과
처리량(초당 출력 토큰 수)
동시성 vLLM 텐서RT-LLM SGLang
1개 필요 120톡/초 130톡/초 125톡/초
10개 필요 650 토크/초 710 토크/초 680톡/초
50개 필요 1,850 토크/초 2,100 토크/초 1,920 토크/초
100개 필요 2,400 토크/초 2,780 토크/초 2,460 토크/초
엔진 컴파일이 완료되면 TensorRT-LLM은 모든 동시 실행 수준에서 가장 우수한 성능을 보입니다. 성능 차이는 낮은 동시 실행 수준에서 가장 작으며(요청 1개당 vLLM보다 8% 빠름), 동시 요청 50개에서 가장 큽니다(13% 빠름). SGLang은 높은 동시 실행 수준에서 vLLM과 TensorRT-LLM의 중간 정도의 성능을 나타냅니다. 낮은 동시 실행 수준에서 SGLang의 RadixAttention은 요청들이 동일한 접두사를 공유할 때만 미미한 처리량 향상을 제공합니다. 본 벤치마크에서는 모든 요청이 고유한 프롬프트를 사용했으므로 기준 동작을 확인할 수 있습니다. 여기에 제시된 처리량 수치는 기본 vLLM 스케줄러 설정을 기준으로 합니다. 연속 배치 처리 및 청크 프리필 튜닝이 이러한 수치에 미치는 영향에 대한 자세한 내용은 LLM 서빙 최적화 심층 분석을 참조하십시오 .
첫 토큰 획득 시간(TTFT, 밀리초)
동시성 vLLM p50 vLLM p95 TRT-LLM p50 TRT-LLM p95 SGLang p50 SGLang p95
1개 필요 45밀리초 68밀리초 38밀리초 55밀리초 42밀리초 61밀리초
10개 필요 120밀리초 195밀리초 105밀리초 170밀리초 112밀리초 178밀리초
50개 필요 380밀리초 720밀리초 340밀리초 620ms 360밀리초 680ms
100개 필요 740ms 1,450밀리초 680ms 1,280밀리초 710ms 1,380밀리초
TTFT는 애플리케이션의 속도를 체감하는 데 중요한 지표입니다. TensorRT-LLM은 모든 동시 실행 수준에서 가장 낮은 p50 및 p95 값을 제공합니다. p95 값의 차이는 특히 부하가 높을 때 두드러집니다. 동시 요청 100개에서 TensorRT-LLM의 p95 TTFT는 1,280ms인 반면 vLLM은 1,450ms입니다. 이 170ms의 차이는 대화형 애플리케이션에서 사용자가 체감하는 응답성에 영향을 미칩니다. SGLang의 p95 값은 테스트된 모든 동시 실행 수준에서 두 프레임워크의 중간 정도에 위치합니다.
최대 VRAM 사용량
엔진 대기 중 (모델 로드됨) 최대 50 요구 최대 100 요구
vLLM 71GB 76GB 78GB
텐서RT-LLM 74GB 77GB 79GB
SGLang 72GB 75GB 78GB
80GB GPU에서 70비트 FP8 모델을 실행할 때 세 프레임워크 모두 VRAM 사용량이 적습니다. TensorRT-LLM의 컴파일된 엔진은 추가 활성화 버퍼를 저장하기 때문에 vLLM(71GB)보다 유휴 VRAM(74GB)을 약간 더 많이 사용합니다. SGLang은 키-값 캐시 관리 덕분에 최대 부하 시 VRAM 사용량이 가장 적습니다. 프레임워크 간의 차이는 4GB 미만이므로 튜닝 여유 공간은 세 프레임워크 모두 비슷합니다. VRAM이 병목 현상이라면 엔진 선택보다는 설정 과 성능에 --max-model-len더 큰 영향을 받습니다 .max-model-lengpu-memory-utilization
콜드 스타트 시간
엔진 첫 요청까지의 시간
vLLM 약 62초
텐서RT-LLM 약 28분 (엔진 컴파일 시간)
SGLang 약 58초
TensorRT-LLM의 컴파일 시간은 결함이 아니라 의도적인 절충안입니다. 28분 정도 소요되는 빌드는 모델 버전당 한 번씩 실행되어 컴파일된 엔진을 디스크에 저장하고, 이후 실행 시에는 저장된 엔진을 재사용합니다(컴파일된 엔진을 다시 로드하는 데 약 90초가 걸립니다). 문제는 배포 파이프라인에 있습니다. 블루-그린 배포, 제로 인스턴스 자동 확장, 또는 잦은 모델 업데이트를 수행하는 경우, 컴파일 시간을 고려하여 계획해야 합니다. vLLM과 SGLang은 모두 90초 이내에 시작되며(디스크에서 모델 가중치를 로드하는 데 시간이 주로 소요됨), 따라서 필요에 따라 인스턴스를 생성하는 자동 확장 정책과 호환됩니다.
컴파일 단계 없이 TensorRT-LLM 성능을 원하신다면 PyTorch 백엔드를 사용하실 수 있습니다. v1.0에서 PyTorch 백엔드가 안정화되었고 기본값으로 설정되어 기존의 플러그인 기반 백엔드를 대체했습니다. 이제 기본값이 되었으므로, 백엔드를 --backend pytorch완전히 생략하거나 명시적으로 전달할 수 있습니다 trtllm-serve. 어느 경우든 HuggingFace 가중치를 직접 로드하여 콜드 스타트 시간을 약 60~90초로 단축합니다. 위의 벤치마크는 컴파일된 TRT 엔진을 사용했지만, PyTorch 백엔드를 사용하면 최대 처리량은 낮아지더라도 컴파일 단계를 완전히 제거할 수 있습니다.
vLLM
vLLM의 핵심 설계는 GPU 메모리를 가상 메모리 페이지처럼 처리하는 KV 캐시 메모리 관리자인 PagedAttention입니다. 이를 통해 vLLM은 요청별 메모리를 미리 예약하지 않고도 많은 동시 요청을 처리할 수 있습니다. 연속 배치 처리(전체 배치를 기다리는 대신 요청이 도착하는 즉시 동적으로 그룹화)와 결합하여, vLLM은 수동 배치 로직 없이도 버스트 트래픽에서 높은 GPU 활용률을 달성합니다. PagedAttention 및 모든 KV 캐시 메모리 기술에 대한 자세한 내용은 " KV 캐시 최적화: 동일한 GPU에서 10배 더 많은 사용자에게 서비스 제공"을 참조하십시오 .
H100에서 FP8은 플래그 하나만 변경하면 작동합니다. 양자화 스크립트도, 모델 수정도 필요 없습니다.
세게 때리다
docker run --gpus all \
--ipc=host \
-p 8000:8000 \
-e HUGGING_FACE_HUB_TOKEN=your_token_here \
vllm/vllm-openai:v0.18.0-cu130 \
--model meta-llama/Llama-3.3-70B-Instruct \
--quantization fp8 \
--max-model-len 8192 \
--gpu-memory-utilization 0.92 \
--max-num-seqs 128 \
--host 0.0.0.0 \
--port 8000
장점: 세 가지 프레임워크 중 가장 폭넓은 모델 지원( Qwen3-VL , Qwen3-Omni , InternVL3 , LLaVA-Next , Pixtral-12B , Baidu ERNIE-4.5-VL 과 같은 멀티모달 모델을 포함한 수백 가지 아키텍처와 Qwen3 , Gemma 3 , DeepSeek R1 & V3 , Phi-4 , Mistral/Mixtral 과 같은 인기 있는 오픈 소스 제품군 포함 ), 컴파일 단계 없음, 간편한 배포, OpenAI 호환 API 기본 제공. gRPC 서빙(를 통해 --grpc)은 오버헤드가 낮은 내부 배포를 위한 REST 대안을 제공합니다. v0.18.0에서는 Ray가 기본 종속성에서 제거되었습니다. pip install ray멀티 노드 텐서 병렬 처리를 사용하는 경우 별도로 설치해야 합니다. --performance-mode throughput(v0.17.0에서 도입된) 플래그는 배치 워크로드에 맞게 설정을 미리 조정합니다. 프로덕션 환경에 대한 전체 배포 가이드는 Spheron의 vLLM 문서 에서 확인할 수 있습니다 .
제한 사항: 높은 동시 접속 환경에서 최대 처리량이 TensorRT-LLM보다 약간 낮으며, 동시 요청 100개에서 TTFT p95가 세 가지 중 가장 높습니다.
참고: 이 벤치마크 결과는 vLLM v0.17.0 이상에서 사용 가능한 MRV2(Model Runner V2) 출시 이전에 측정되었습니다 VLLM_USE_V2_MODEL_RUNNER=1. vLLM MRV2 가이드 에는 MRV2 활성화 후 업데이트된 수치가 포함되어 있으며, GB200 데이터셋에서 기존 러너 대비 처리량이 56% 향상되었습니다(H100 데이터셋에서의 결과는 다를 수 있습니다).
이러한 엔진들보다 2~5배 더 빠른 지연 시간 개선을 위해서는 서빙 계층에서 투기적 디코딩을 활성화할 수 있습니다. 자세한 내용은 vLLM 및 SGLang 구성에 대한 투기적 디코딩 프로덕션 가이드를 참조하십시오.
텐서RT-LLM
TensorRT-LLM은 NVIDIA의 컴파일러 기반 접근 방식입니다. 일반적인 PyTorch 런타임을 통해 모델 가중치를 처리하는 대신, TensorRT-LLM은 특정 GPU, 배치 크기 및 시퀀스 길이 구성에 맞춰 최적화된 CUDA 커널 그래프로 모델을 컴파일합니다. 결과적으로 컴파일된 엔진 바이너리는 어떤 런타임 기반 접근 방식보다 하드웨어 효율성을 극대화합니다. 컴파일된 엔진 그래프에 의존하는 대신 사용자 지정 CUDA 커널을 작성하려는 팀의 경우, 새로운 CUDA 13 타일 프로그래밍 모델을 통해 Python 우선 방식으로 커널 성능을 수동으로 조정할 수 있습니다.
전체 빌드 파이프라인에 대한 자세한 내용은 TensorRT-LLM 프로덕션 배포 가이드를 참조하세요 .
벤치마크를 위한 빌드 파이프라인은 다음과 같습니다.
세게 때리다
# Pull the TensorRT-LLM container
docker pull nvcr.io/nvidia/tensorrt-llm/release:1.2.0
# Step 1: Quantize HuggingFace weights to FP8 checkpoint (~5 min on H100)
docker run --gpus all --ipc=host \
-v /path/to/model:/models \
-v /path/to/engine:/engines \
nvcr.io/nvidia/tensorrt-llm/release:1.2.0 \
python examples/quantization/quantize.py \
--model_dir /models/Llama-3.3-70B-Instruct \
--dtype float16 \
--qformat fp8 \
--kv_cache_dtype fp8 \
--output_dir /engines/fp8-checkpoint \
--calib_size 512
# Step 2: Build the TRT engine from the FP8 checkpoint (~23 min on H100)
docker run --gpus all --ipc=host \
-v /path/to/engine:/engines \
nvcr.io/nvidia/tensorrt-llm/release:1.2.0 \
trtllm-build \
--checkpoint_dir /engines/fp8-checkpoint \
--output_dir /engines/llama70b-engine \
--max_batch_size 128 \
--max_input_len 8192 \
--max_seq_len 10240
# Run the OpenAI-compatible server
docker run --gpus all --ipc=host -p 8000:8000 \
-v /path/to/engine:/engines \
nvcr.io/nvidia/tensorrt-llm/release:1.2.0 \
trtllm-serve /engines/llama70b-engine --port 8000 --host 0.0.0.0
v1.2.0 빌드 파이프라인은 두 단계로 구성됩니다. 먼저 modelopt의 명령어를 사용하여 HuggingFace 가중치를 TRT-LLM FP8 체크포인트로 양자화한 quantize.py다음, 컴파일합니다 trtllm-build --checkpoint_dir. trtllm-serve(v0.15.0에서 추가된) 이 명령어는 기존의 명령어를 대체합니다 launch_server.py. 컨테이너 경로는 NGC 릴리스 레지스트리( nvcr.io/nvidia/tensorrt-llm/release:1.2.0)이며, (CUDA 13.1.0)을 기반으로 합니다 nvcr.io/nvidia/pytorch:25.12-py3. CUDA 13.0(vLLM 및 SGLang cu130 컨테이너에서 사용)은 Linux에서 드라이버 580.65.06 이상을 필요로 하며, CUDA 13.1(TRT-LLM 1.2.0에서 사용)은 드라이버 590.44.01 이상을 필요로 합니다. 본 설정에서 사용된 590.48.01 드라이버는 두 요구 사항을 모두 충족합니다. 드라이버 버전이 일치하지 않으면 모호한 빌드 오류가 발생하므로, 시작하기 전에 드라이버 버전을 확인하십시오.
v1.2.0 버전에서는 DGX Spark 검증(베타)이 추가되었고, DeepSeek V3.2 지원이 확장되었습니다(MTP>1인 경우 투기적 디코딩). DeepSeek V3/R1 지원은 TensorRT-LLM v0.19.0에서 처음 추가되었으며, v1.0, v1.1, v1.2 버전에 걸쳐 추가적인 최적화가 이루어졌습니다. Spheron에서 DeepSeek을 실행하는 경우, Spheron DeepSeek R1 및 V3 가이드를 참조하십시오 .
전체 배포 지침은 Spheron의 TensorRT-LLM 문서 에서 확인할 수 있습니다 .
장점: 모든 동시 실행 수준에서 최고의 처리량, 최저 p50 및 p95 TTFT, 고정 구성에서 최상의 하드웨어 활용률. PyTorch 백엔드(v1.0 이상)는 컴파일 요구 사항을 제거하지만, 최대 처리량은 다소 감소합니다. 단점: 컴파일된 엔진 경로는 모델 버전당 28분의 빌드 시간이 소요됩니다. vLLM보다 지원하는 모델 범위가 제한적입니다. 컴파일된 경로의 배포 파이프라인이 더 복잡합니다.
SGLang
SGLang의 핵심 혁신은 RadixAttention입니다. RadixAttention은 토큰 시퀀스를 키로 하는 라딕스 트리에 캐시된 어텐션 활성화를 저장하는 KV 캐시 관리 시스템입니다. 두 요청이 공통 접두사(시스템 프롬프트, 문서, few-shot 예제 등)를 공유하는 경우, SGLang은 해당 접두사에 대한 KV 캐시를 한 번만 계산하고 이를 공유하는 모든 요청에 재사용합니다. 긴 접두사를 공유하는 워크로드에서 이는 TTFT(처리 시간)와 계산 비용을 크게 줄여줍니다.
세게 때리다
docker run --gpus all \
--ipc=host \
-p 8000:8000 \
-e HUGGING_FACE_HUB_TOKEN=your_token_here \
lmsysorg/sglang:v0.5.9-cu130-runtime \
python -m sglang.launch_server \
--model-path meta-llama/Llama-3.3-70B-Instruct \
--quantization fp8 \
--context-length 8192 \
--mem-fraction-static 0.92 \
--max-running-requests 128 \
--host 0.0.0.0 \
--port 8000
SGLang은 투기적 디코딩 지원과 제약 조건 생성(JSON 스키마, 정규 표현식)을 위한 구조화된 출력 엔진을 포함합니다. 구조화된 출력 구현은 vLLM의 가이드 디코딩과 유사한 성능을 제공합니다. v0.5.9에서는 OpenAI 호환 엔드포인트와 함께 네이티브 Anthropic API 호환성이 추가되어, 애플리케이션이 이미 Anthropic SDK를 대상으로 하는 경우 유용합니다. 또한, 같은 릴리스에서 TRT-LLM DSA(DeepSeek Sparse Attention) 커널이 DeepSeek V3.2용 SGLang의 네이티브 스파스 어텐션(NSA) 백엔드에 통합되어 Blackwell에서 3~5배의 속도 향상을 제공하며 --nsa-prefill-backend trtllm, Qwen3.5, Kimi-K2.5--nsa-decode-backend trtllm , GLM-5, MiniMax 2.5 모델까지 지원합니다 . 전문가 병렬 처리 플래그를 사용하여 754B MoE 모델을 배포하는 예제는 GLM-5.1 GPU 클라우드 가이드를 참조하십시오 . 이번 릴리스에서는 LoRA 가중치 로딩과 연산 간의 중첩 기능이 추가되어 LoRA 어댑터 워크로드의 TTFT(처리 시간)가 약 78% 감소합니다. 이러한 프레임워크를 사용한 멀티 어댑터 서빙의 전체 프로덕션 설정에 대해서는 GPU 클라우드에서의 LoRA 멀티 어댑터 서빙을 참조하십시오 . Spheron에서의 DeepSeek 배포에 대해서는 DeepSeek R1 및 V3 가이드를 참조하십시오 .
전체 문서: Spheron의 SGLang 가이드 . 멀티 GPU 설정, 접두사 캐싱 튜닝 및 모니터링을 포함한 SGLang 프로덕션 배포에 대한 자세한 내용은 SGLang 프로덕션 배포 가이드를 참조하십시오 .
장점: 공유 접두사 캐싱 적용 시 최상의 TTFT(Time To First Time), vLLM과 경쟁력 있는 처리량, 빠른 콜드 스타트, 강력한 구조화된 출력 지원. 단점: 고유한 프롬프트 워크로드에서는 RadixAttention의 이점이 사라집니다. 당사의 벤치마크(모든 프롬프트가 고유한 경우)에서 SGLang의 vLLM 대비 처리량 우위는 미미했습니다.
SGLang vs vLLM: 대부분의 팀이 실제로 맞붙는 대결
TensorRT-LLM의 컴파일 파이프라인 때문에 벤치마크를 실행하기도 전에 많은 팀들이 사용을 포기하게 되므로, 실질적인 선택은 보통 SGLang과 vLLM 중에서 고민하게 됩니다. 저희가 진행한 고유 프롬프트 H100 벤치마크 결과, 두 엔진의 처리량은 불과 몇 퍼센트 차이밖에 나지 않았습니다. 이는 엔진의 최고 성능 수치보다는 워크로드 형태가 선택에 더 중요하다는 것을 의미합니다. 요청들이 시스템 프롬프트, 몇 회 실행된 예제, 또는 RAG 컨텍스트를 공유하는 경우, SGLang의 RadixAttention이 캐시된 접두사를 재사용하여 TTFT(Time To First Time) 측면에서 유리합니다. 프롬프트가 대부분 고유한 경우에는 vLLM의 더 폭넓은 모델 지원, 더 큰 커뮤니티, 그리고 컴파일 없이 바로 시작할 수 있다는 장점 때문에 vLLM이 더 안전한 선택이 될 수 있습니다. 요컨대, 먼저 접두사 중복률을 측정해야 합니다. 접두사 공유 트래픽이 약 60% 이상이면 SGLang을 선택하고, 그 이하이면 vLLM을 선택한 후 기능을 활성화하여 --enable-prefix-caching나머지 차이를 줄이세요.
각 엔진은 언제 사용해야 할까요?
상태 추천 엔진
다양한 모델을 지원해야 합니다. vLLM
장기 생산에서 한 가지 모델을 제공하고 있습니다. 텐서RT-LLM
사용자의 워크로드에는 공유 시스템 프롬프트 또는 RAG 컨텍스트가 있습니다. SGLang
전원을 켠 후 2분 이내에 온라인에 접속해야 합니다. vLLM, SGLang 또는 TRT-LLM PyTorch 백엔드
100명 이상의 동시 접속 환경에서 최고의 처리량을 원하시죠? 텐서RT-LLM
당신은 실험 또는 프로토타입 제작을 하고 있습니다. vLLM
귀 팀의 DevOps 역량이 제한적입니다. vLLM
대규모로 다중 턴 대화를 운영할 수 있습니다. SGLang
대부분의 팀은 vLLM 으로 시작하는 것이 좋습니다 . vLLM은 가장 광범위한 모델 범위를 지원하고, 최고의 문서화를 제공하며, 컴파일 단계가 필요 없고, 대부분의 워크로드에서 경쟁력 있는 처리량을 제공합니다. 몇 달 동안 모델이 변경되지 않고 대규모 환경에서 초당 모든 토큰을 최대한 처리해야 하는 경우 TensorRT-LLM 으로 전환하십시오. 공유 접두사 워크로드에서 TTFT를 측정하고 사용자 경험이 크게 향상되는 것을 확인하면 SGLang 으로 전환하십시오 . 트래픽 형태가 변경될 때마다 위의 표에서 다시 도출하는 것보다 반복 가능한 프레임워크를 사용하고 싶다면, NVIDIA의 LLM 추론 최적화 결정 프레임워크를 통해 접두사 중복 비율을 기반으로 동일한 수치를 경험 법칙으로 변환할 수 있습니다. 문법 캐싱, 에이전트 루프용 RadixAttention, 에이전트 호출당 비용 계산을 포함한 구조화된 출력 성능에 대한 자세한 내용은 구조화된 출력 추론 최적화 가이드를 참조하십시오 . 수동 TRT-LLM 컴파일 없이 바로 사용할 수 있는 컨테이너를 원한다면 NVIDIA NIM에서 엔진, 가중치 및 API를 단일 컨테이너에 번들로 제공합니다. 더 가벼운 대안을 원한다면, 소규모 모델에 적합한 llama.cpp , LMDeploy의 TurboMind 엔진 , LocalAI 도 Spheron 인스턴스에서 사용할 수 있습니다. Docker 설정 없이 브라우저 기반으로 실험하려면 Ollama + Open WebUI 가이드 에서 더 간단한 방법을 확인할 수 있습니다. GPT-OSS 20B 및 120B MoE에서 vLLM과 SGLang의 모델별 비교(MXFP4 양자화 관련 장단점 포함)는 GPT-OSS 배포 가이드를 참조하세요 . 단일 엔진 배포 대신 Python 기반 멀티 모델 오케스트레이션을 사용하려면 Ray Serve GPU 클라우드 LLM 배포 가이드에서 이러한 엔진들을 활용한 파이프라인 구성 방법을 다룹니다. 관리형 API 비용이 너무 높아 자체 호스팅 엔진을 고려하고 있다면, Hugging Face Inference Endpoints 대안 가이드 에서 10개 제공업체의 비용 비교를 확인할 수 있습니다.
Spheron에서 5분 만에 배포
먼저 Spheron H100 인스턴스를 프로비저닝 하고 SSH로 접속한 후, 명령어를 사용하여 GPU 접근 권한을 확인하세요 nvidia-smi. Spheron을 처음 사용하는 경우, 빠른 시작 가이드 에서 첫 인스턴스 프로비저닝 및 CUDA 접근 권한 확인 방법을 안내합니다. Spheron 문서 개요에서는 인스턴스 유형 및 시작 방법을 다룹니다. 아래 명령어 외에 더 자세한 구성 정보가 필요한 경우, Spheron LLM 빠른 시작 가이드 에서 세 가지 프레임워크 가이드를 모두 확인할 수 있습니다.
vLLM
세게 때리다
# Start the server
docker run --gpus all --ipc=host -p 8000:8000 \
-e HUGGING_FACE_HUB_TOKEN=your_token_here \
vllm/vllm-openai:v0.18.0-cu130 \
--model meta-llama/Llama-3.3-70B-Instruct \
--quantization fp8 \
--max-model-len 8192 \
--gpu-memory-utilization 0.92 \
--host 0.0.0.0 \
--port 8000
# Verify the endpoint
curl http://localhost:8000/v1/models
전체 가이드: Spheron vLLM 문서
텐서RT-LLM
먼저 엔진을 빌드하십시오(1회성, 약 28분 소요). 그런 다음 서버를 시작하십시오. 빌드 명령은 위의 TensorRT-LLM 섹션을 참조하십시오.
세게 때리다
# After building the engine, start the server
docker run --gpus all --ipc=host -p 8000:8000 \
-v /path/to/engine:/engines \
nvcr.io/nvidia/tensorrt-llm/release:1.2.0 \
trtllm-serve /engines/llama70b-engine --port 8000 --host 0.0.0.0
# Verify
curl http://localhost:8000/v1/models
전체 가이드: Spheron TensorRT-LLM 문서
SGLang
세게 때리다
# Start the server
docker run --gpus all --ipc=host -p 8000:8000 \
-e HUGGING_FACE_HUB_TOKEN=your_token_here \
lmsysorg/sglang:v0.5.9-cu130-runtime \
python -m sglang.launch_server \
--model-path meta-llama/Llama-3.3-70B-Instruct \
--quantization fp8 \
--context-length 8192 \
--mem-fraction-static 0.92 \
--host 0.0.0.0 \
--port 8000
# Verify
curl http://localhost:8000/v1/models
전체 가이드: Spheron SGLang 문서 | SGLang 프로덕션 배포 가이드
이 세 가지 프레임워크 중 어떤 것을 선택할지는 배포 제약 조건에 따라 달라집니다. 컴파일에 28분이 소요되고 모델이 안정적이라면 TensorRT-LLM이 최고의 처리량과 지연 시간을 제공합니다. 빠른 시작과 모델 유연성이 필요하다면 vLLM이 적합한 기본 프레임워크입니다. 워크로드가 공유 접두사를 중심으로 구축된 경우 SGLang의 RadixAttention은 다른 두 프레임워크에서는 얻을 수 없는 실질적인 성능 향상을 제공합니다. 하나의 GPU 환경에서 여러 모델 유형을 사용하는 팀의 경우 Triton Inference Server 배포 가이드를 참조하십시오 .
대규모 멀티노드 추론을 실행하는 경우, 이러한 엔진 위에 오케스트레이션 계층을 추가하는 방법에 대한 NVIDIA Dynamo 분산 추론 가이드를 참조하세요.
대규모 환경에서 이러한 처리량 차이가 월별 청구서에 어떤 영향을 미치는지, 특히 스팟 전략과 온디맨드 전략, 공급업체 비용 비교 등을 종합적으로 살펴보려면 " 2026년 AI 추론 비용 경제학"을 참조하십시오 .
이러한 추론 벤치마크를 실행하려면 CUDA에 대한 완전한 접근 권한이 있는 H100 하드웨어가 필요합니다. Spheron은 가상화 오버헤드 없이 온디맨드 방식으로 프로비저닝되고 장기 계약 없이 시간당 2.01달러에 베어메탈 H100 인스턴스를 제공합니다.
H100 재고 확인 → | 모든 GPU 가격 보기 → | Spheron 시작하기 →
FAQ / 05
자주 묻는 질문
vLLM이 TensorRT-LLM보다 더 빠른가요?
H100에서 TensorRT-LLM 엔진 컴파일에 걸리는 시간은 얼마나 되나요?
SGLang의 RadixAttention이란 무엇이며, 언제 유용하게 사용될 수 있나요?
API 호출을 변경하지 않고 추론 엔진을 바꿀 수 있나요?
대규모 프로덕션 LLM 서비스에 가장 적합한 추론 엔진은 무엇입니까?